在最新的 InferenceX AgentX 榜单中,TileRT 驱动 GLM-5.3,在 8 卡 AMD Instinct MI355X GPU 上实现了 469 tok/s 的单用户生成速度,登顶 AgentX 榜单,领先第二名 NVIDIA GB300 NVL72 超过 100 tok/s。
1. AgentX:真实 Agent 长程任务下的 469 tok/s
AgentX 测的是什么?
InferenceX(原 InferenceMAX)由 SemiAnalysis 主导,是一个开源、厂商中立、可复现的推理基准。AgentX 关注能够反映 Coding Agent 真实运行方式的工作负载下的推理性能。
这与常见的固定 Prompt 长度基准有很大不同。
AgentX 的工作负载来自真实 Coding Agent 的运行轨迹。为了保证基准的可复现性,原始内容会被移除,并使用确定性的合成 Token 重建,同时保留原始会话的结构:多轮交互、持续增长的共享前缀、工具调用带来的停顿,以及主 Agent 与 Sub-agent 之间的依赖关系。
换句话说,AgentX 衡量的是完整 Agent 会话中的推理性能。随着任务不断推进、上下文持续增长,模型能否维持较高的生成速度会变得越来越重要。
469 tok/s:AgentX 单用户性能第一
在 AgentX 工作负载上,TileRT 驱动 GLM-5.3,在 8× AMD Instinct MI355X GPU 上实现:
对于长程 Agent 任务,TileRT 选择不以牺牲数值精度来换取速度。在保持原始 FP8 权重精度和 BF16 KV Cache 的情况下,TileRT 仍然取得了目前 AgentX 榜单上最快的单用户成绩,领先第二名采用 FP4 的 NVIDIA GB300 NVL72 超过 100 tok/s。
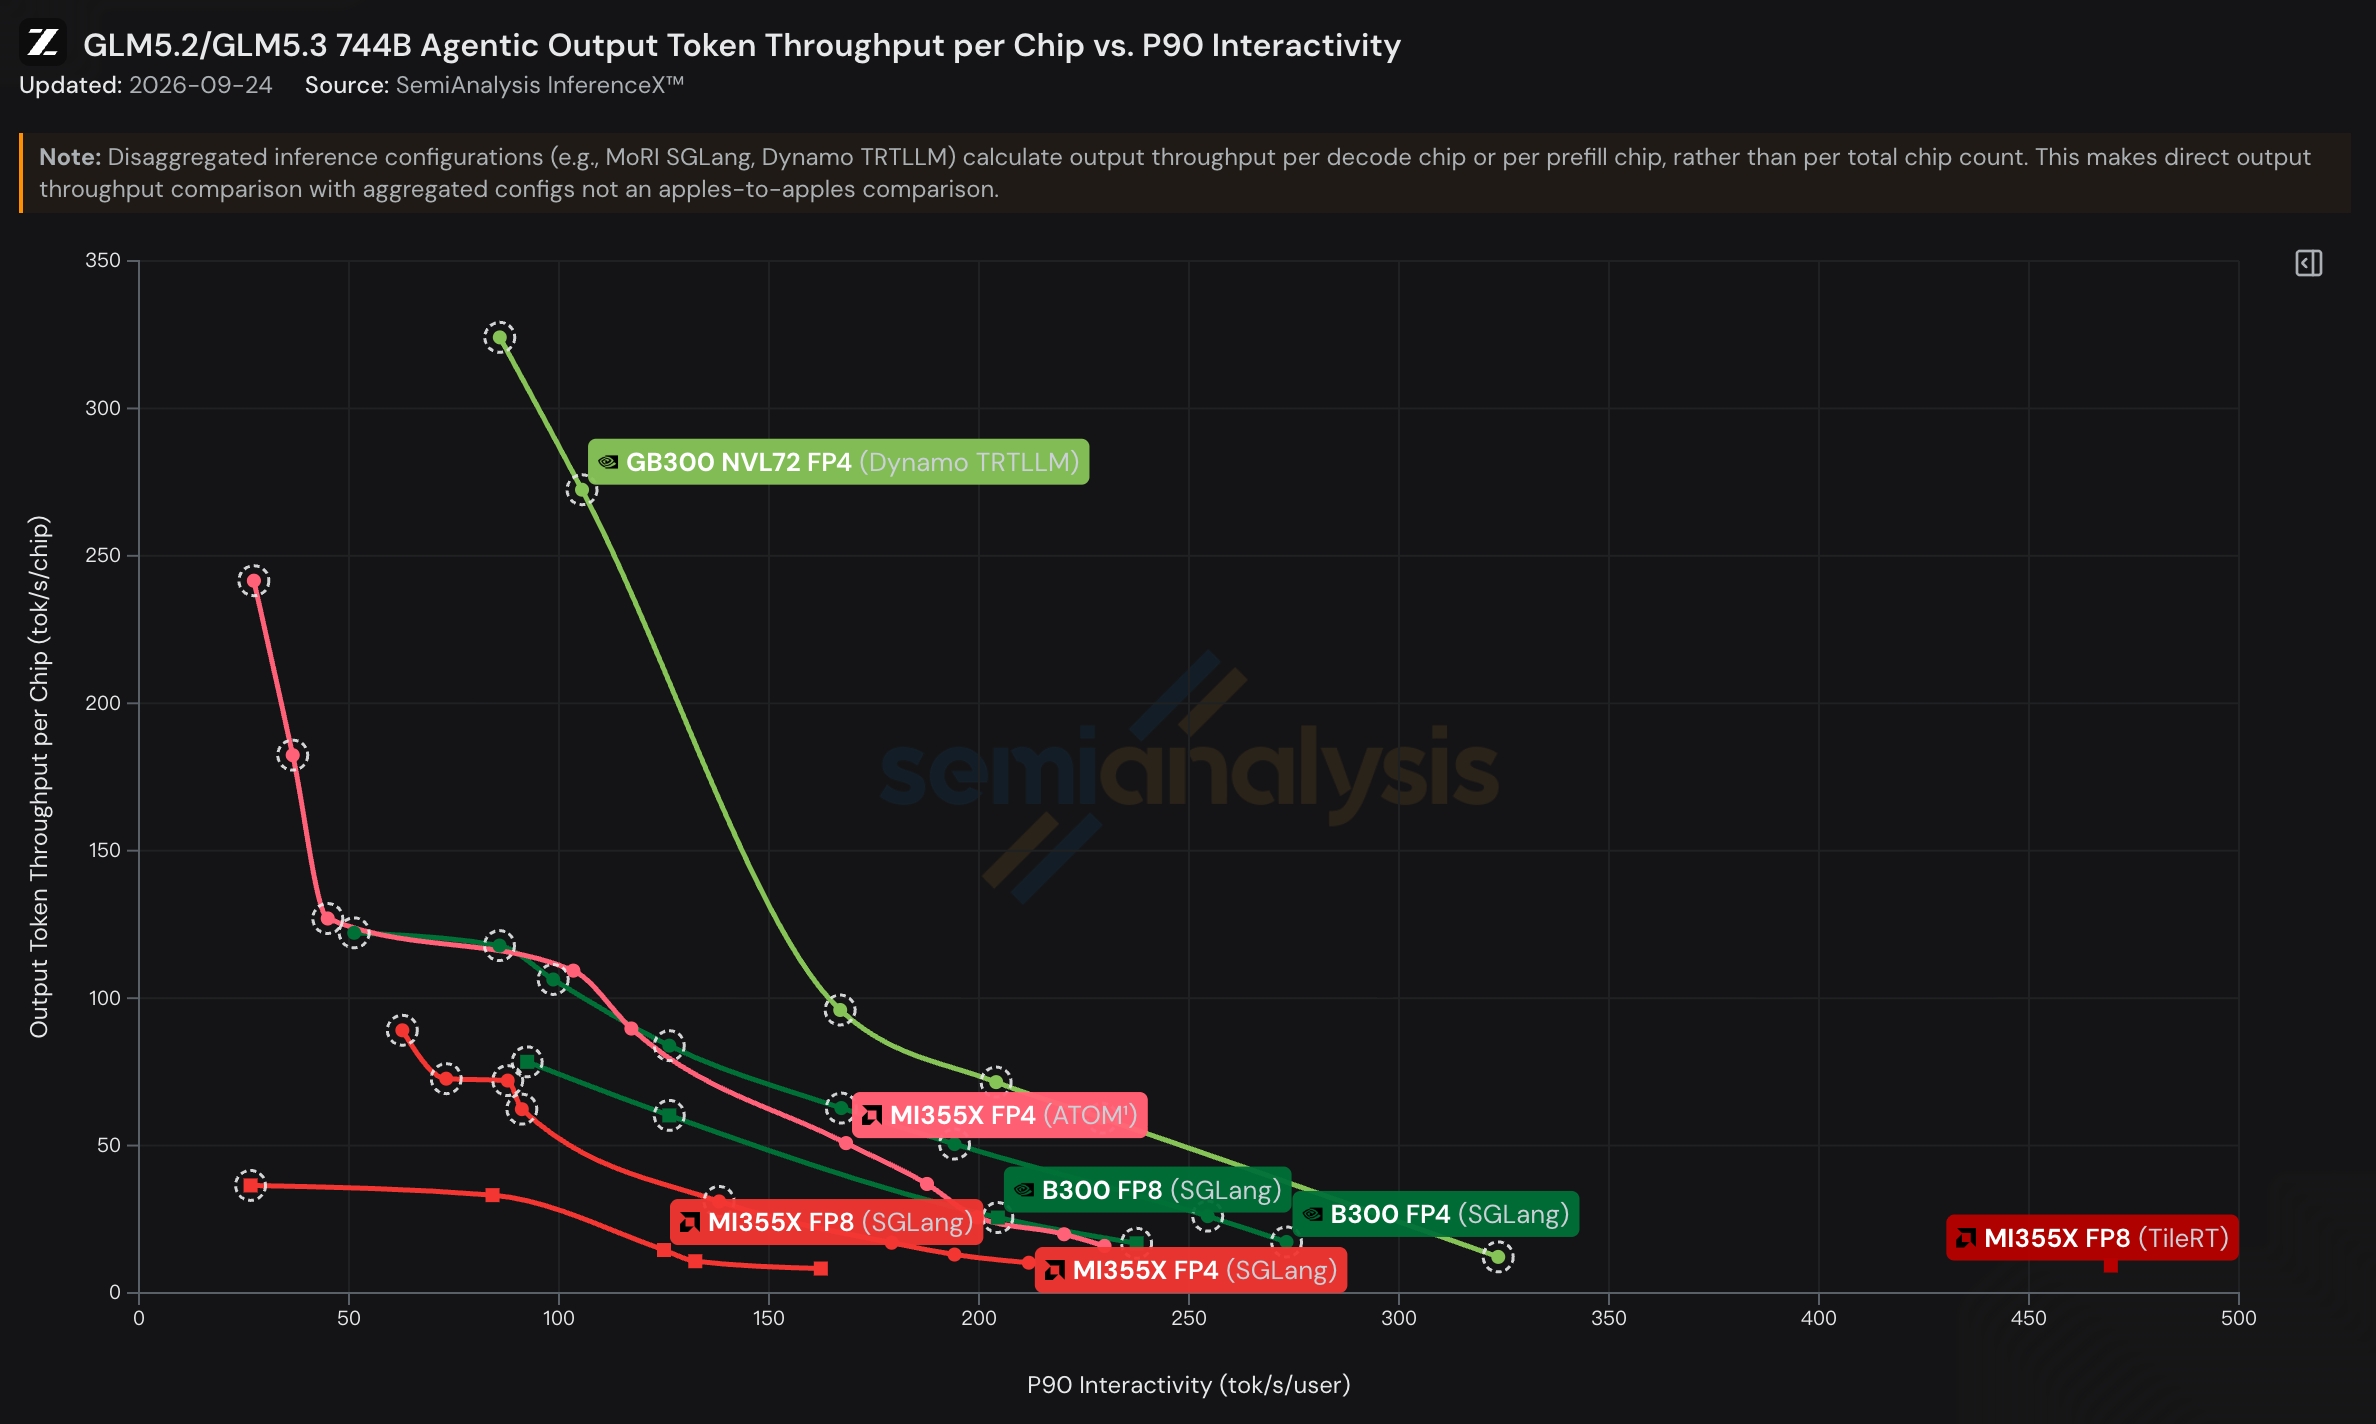
从 1K 到 1M,上下文增长 1000× 后仍保持约 2/3 的速度
除了 AgentX 最终取得的 469 tok/s,我们还非常关注另一个指标:随着上下文不断增长,性能还能保持多少?
AgentX 会话可以增长到数百万 Token。随着上下文变长,每生成一个新的 Token 都需要访问越来越大的 KV Cache,解码阶段的显存访问开销也会随之增加。因此,短上下文下跑得快,并不意味着在长时间运行的 Agent 工作负载下仍然能保持同样的交互体验。
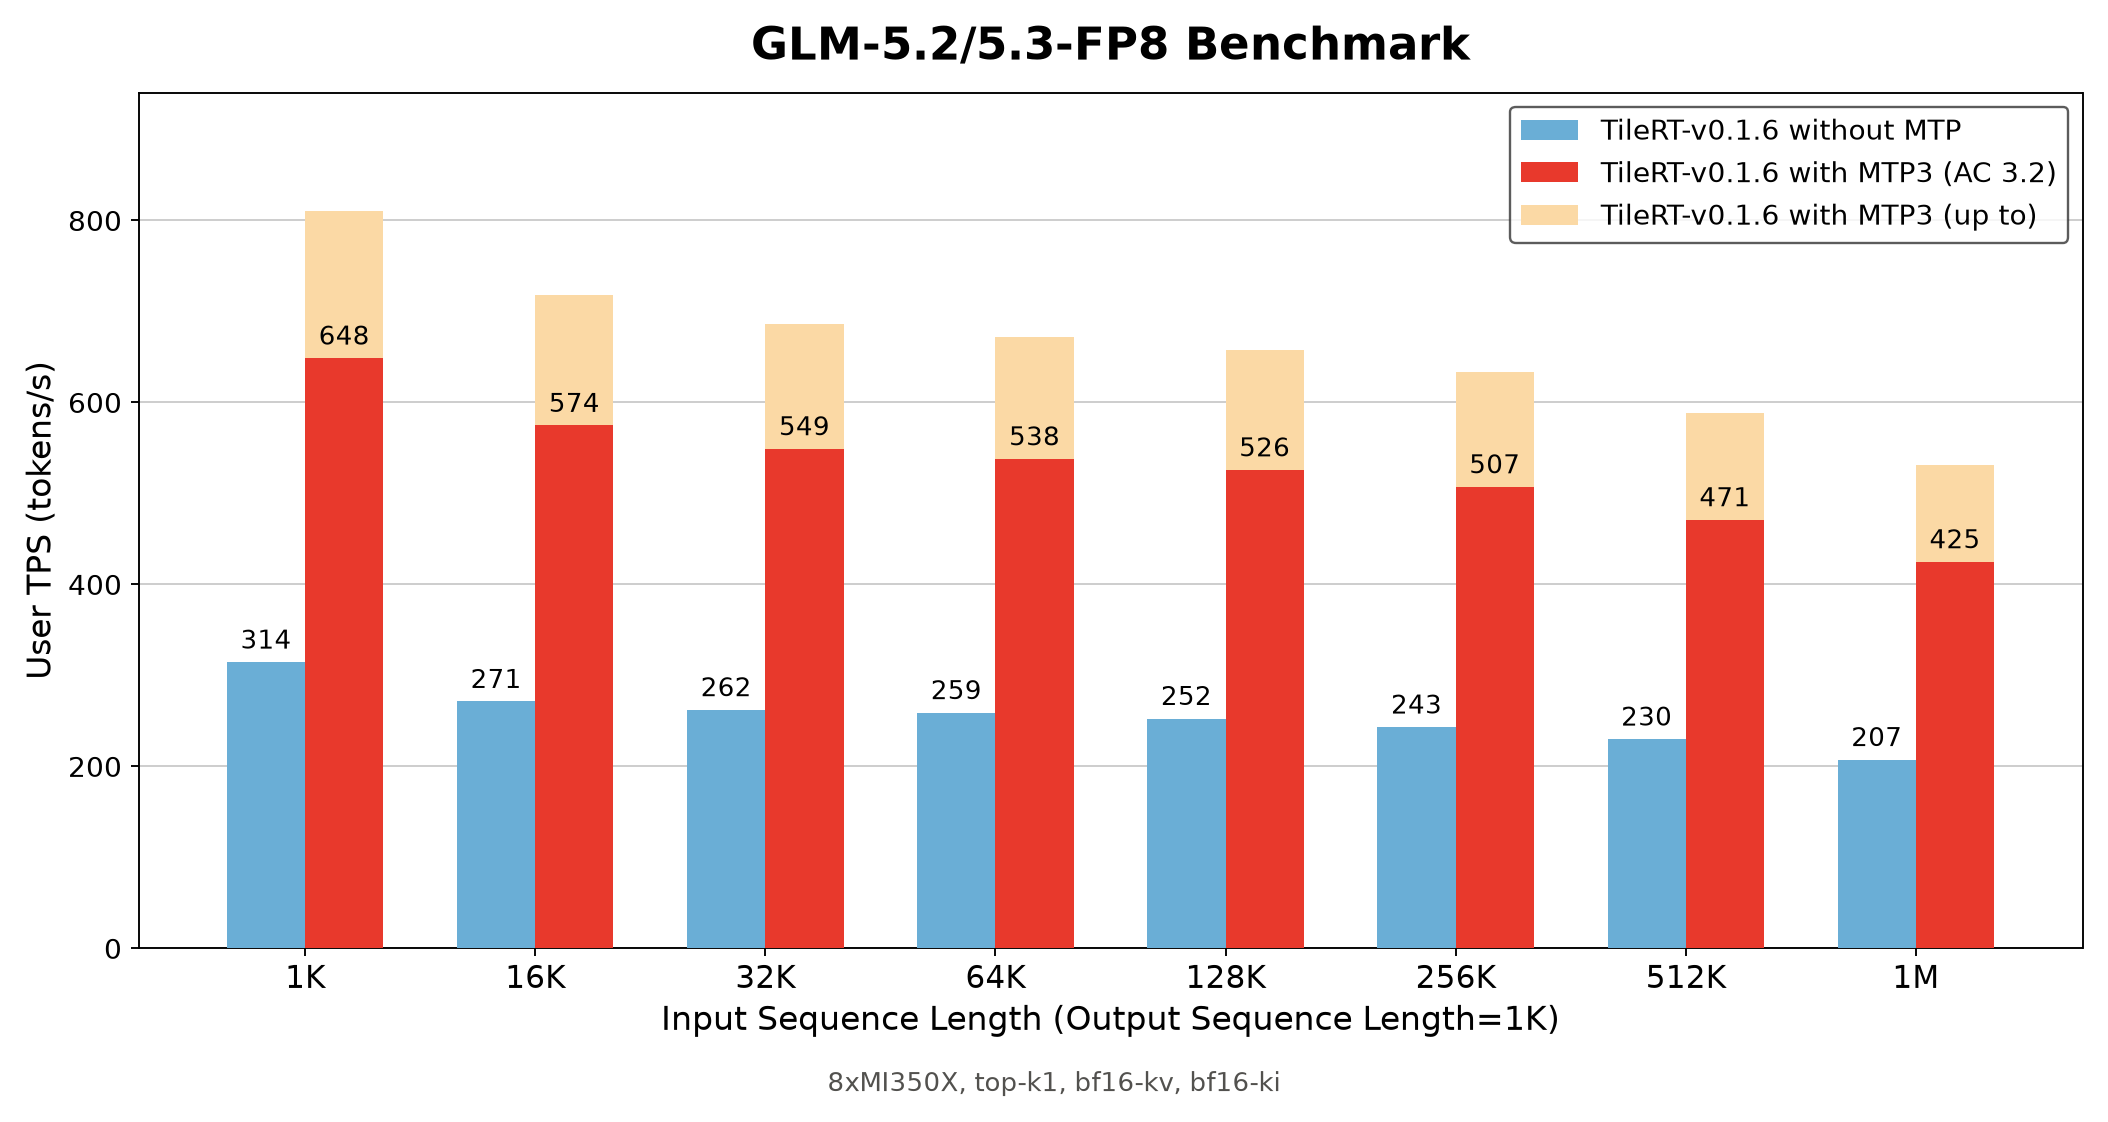
如图 2 所示,当输入上下文从 1K 增长到 1M Token,长度增长 1000× 时,单用户生成速度从 648 tok/s 降至 425 tok/s。即使在百万 Token 上下文下,TileRT 仍能保持短上下文时约 2/3 的性能。
这对于 Agent 工作负载非常重要。真实的 Agent 会话会不断累积上下文,随着任务运行时间变长,长上下文下的解码性能会越来越直接地决定用户感受到的交互速度。
图 2 来自我们在 8× MI350X 上的开发测试,而 AgentX 榜单成绩使用的是 8× MI355X。MI350X 和 MI355X 均基于 CDNA 4 架构,但 MI350X 的运行频率更低。因此,相比 AgentX 所使用的 MI355X 配置,图 2 的结果可以看作一个相对保守的参考。
测试配置:AgentX 榜单成绩使用 8× MI355X;图 2 的长上下文解码测试使用 8× MI350X。两组测试均采用 TP8、公开发布的 GLM-5.3 权重、FP8,以及 MTP K=3 投机解码。榜单测试的完整配置请参见我们的 InferenceX 提交。
2. TileRT 是怎么做到的
TileRT 从一开始就是为低延迟而设计的。
大家谈 scaling law,通常关注模型参数和训练数据。但对于 Agent,我们认为还有另一个重要的维度:速度。更快的推理意味着 Agent 可以在相同时间内完成更多轮思考、工具调用和环境交互。从这个意义上说,速度本身也是智能 scaling 的一个维度。
在以低延迟为核心的场景中,随着硬件算力和显存带宽不断提升,一次解码 forward 中真正用于计算的时间已经越来越短。与此同时,kernel launch、跨 kernel 同步、global memory 往返等额外开销开始进入关键路径。
这些开销在以吞吐为主的场景中往往会被计算掩盖,但在追求极致低延迟时会越来越明显。我们将其称为 execution gap。
TileRT 的核心思路,是在编译期将整个模型静态展开为一个常驻 GPU 的 Engine Kernel。计算、通信和异步 I/O 都在其中持续推进,不再逐个启动 kernel,也不再受限于 kernel 边界。优化的范围由单个 kernel 扩展到了整个 forward。
在 MI355X 上,我们主要从三个方向进一步压缩 execution gap。
2.1 从全局屏障到流式同步
执行流进入常驻 kernel 后,kernel boundary 消失了,原本由它保证的全局同步也随之消失。传统做法是设置全局屏障:等所有 block 都完成计算和写回,再统一进入下一阶段。
TileRT 不做这种全局对齐。上游完成一部分数据,就可以立即交给下游;下游一边等待,一边消费已经就绪的数据。通过流式的生产者-消费者握手,原本前后串行的两个阶段可以持续重叠,减少全局同步带来的等待。
这一优化在 AMD 架构上的收益尤其明显。
2.2 把预取做进整个执行流水线
预取(Prefetch)是隐藏访存延迟的关键手段。NVIDIA 的 PDL 允许后一个 kernel 在前一个 kernel 尚未完全结束时提前启动,从而更早开始数据准备。
TileRT 的 persistent Engine 则进一步消除了 kernel boundary。整个 forward 都在 Engine Kernel 中持续执行,后续阶段需要的数据可以更早开始搬运,而不必等待“下一个 kernel”进入调度。
因此,TileRT 可以在整个 forward 范围内决定什么时候开始预取、提前多远、搬哪些数据,让数据搬运和计算实现比 PDL 更激进的重叠。
2.3 通算融合
TP8 下,all-reduce 同样位于解码延迟的关键路径上。
常规实现通常把集合通信作为独立调用插在计算 kernel 之间,采用 ring 或 reduce-scatter + all-gather。它们擅长充分利用链路带宽,但需要多轮传输和同步;而在解码阶段的小消息、低延迟场景里,决定延迟的往往不是峰值带宽,而是通信轮数。
TileRT 采用一次性推送加本地有序归约:每个 rank 将自己的数据直接写入所有 peer 的对称缓冲区,再在本地按固定顺序完成归约,省掉多轮传输和独立的同步阶段。
同时,这套通信并不是一个独立 kernel,而是直接融合进 TileRT 的执行流水线。计算和通信可以持续重叠,进一步缩短一次 forward 的关键路径。
3. 为什么这条路在 AMD 上走得更远
做到这个程度的延迟优化,需要绕开很多现成的软件抽象,直接面向硬件。能走多远,很大程度上取决于硬件架构向软件暴露了多少能力。
MI355X 所基于的 CDNA 4 在几个关键点上,恰好提供了 TileRT 需要的条件。
寄存器空间。预取本质上是在用空间换时间:数据搬得越早,在途数据越多,寄存器压力也越大。CDNA 每个计算单元拥有更大的寄存器堆,单线程可寻址的寄存器数量也更高。对于 TileRT 的 persistent Engine,这意味着在相同 occupancy 下可以保留更多在途数据,把预取做得更深,也能同时重叠更多执行阶段。
分片缓存与细粒度的访存控制。CDNA 将 GPU 划分为多个计算分片,每个分片拥有自己的本地缓存,同时允许软件通过访存指令控制数据的可见范围和缓存行为。这让同一分片内的跨 block 数据交换可以通过更轻量的方式完成,而不必频繁依赖设备级同步。
这正适合 TileRT 的生产者-消费者执行模型:哪些 block 放在一起、谁和谁交换数据,可以由运行时主动安排。原本的硬件分片边界,也因此变成了可以利用的局部性层级。
ISA 级控制权。当优化进入 persistent execution 这个层次,指令调度、访存作用域、预取深度等细节都会直接影响最终延迟,而这些决策很难完全交给编译器。
CDNA 允许通过 inline assembly 直接控制最终执行的 ISA。配合开放、可反汇编的工具链,我们可以先看到编译器实际生成了什么,再对性能关键路径做针对性的调整。
这给 TileRT 留出了很大的软件优化空间:硬件提供能力,软件决定如何调度和组合这些能力。
我们越来越相信,对于快速演进的 AI 工作负载,架构向软件暴露更多能力是一件好事。随着运行时和编译器对硬件的掌控能力不断增强,软件可以承担更多过去需要固化在硬件里的决策。
TileRT 在 MI355X 上的结果,是我们对这条路线的一次验证。
4. 怎么用,以及接下来
TileRT 已经发布在 PyPI 上,可以直接安装:
pip install tilert接下来,TileRT 会沿着几个方向继续推进:
- ROCm 与 MI355X 正式支持。我们会在 GitHub 上正式 release 支持 ROCm 的版本,MI355X 也将成为 TileRT 正式支持的平台之一。
- 更多 batch size。TileRT 目前重点优化 batch 1 的极致 interactivity;batch 2、4 以及更大的 batch 也已经在 roadmap 中,我们会根据实际 workload 和用户需求持续推进。
TileRT 与 AMD 也会继续在高性能推理方向深入合作。
我们还会继续往下走:更低的延迟、更长的上下文、更充分地释放硬件能力。随着 Agent 工作负载变得越来越复杂,我们相信,推理速度本身会成为越来越重要的 scaling 维度。
合作交流
TileRT 团队会继续在高性能 AI 系统的底层构建与极限上探索,也非常欢迎大模型团队和 AI 应用团队跟我们深度合作。如果你对 GPU 架构、编译优化、分布式执行或大规模推理系统有兴趣,欢迎加入我们。
- 主页: tilert.ai
- 开源代码库(部分模块): github.com/tile-ai/TileRT
- 交流或简历: contact@tilert.ai